
数字货币区块数据存储:链上数据膨胀怎么破
干了八年节点数据管理,越来越觉得区块存储不是单纯的技术问题,而是资源问题。比特币主链数据已超700GB,以太坊链上数据体量更大,每上一个新节点都得扛住这份持续膨胀的重量。
最头疼的是全节点同步。一个新人想做链上数据分析,跑个本地节点,光下载历史区块就得等两三天数字货币区块数据存储,硬盘空间不够还得加盘。很多中小团队根本养不起全节点数字货币区块数据存储:链上数据膨胀怎么破,只能依赖第三方RPC服务,数据主权和查询速度全握在别人手里。
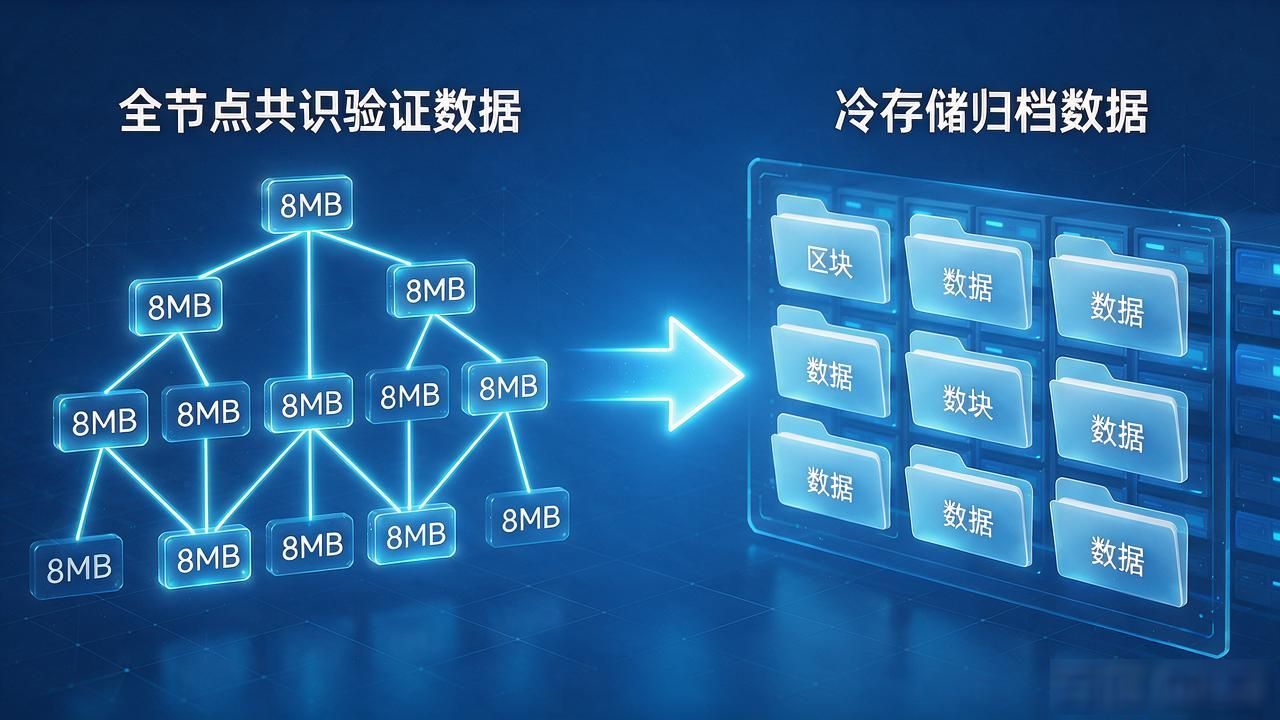
现在主流做法是分层存储。全节点只保留最近约8MB的区块数据做共识验证,更早的区块压缩后归档到冷存储。以太坊的状态修剪机制把不活跃账户从内存状态树中踢出去,节点磁盘占用直接砍到原来的五分之一,小团队也能跑得动。
分片是另一个绕不开的方向。以太坊2.0把验证者数据拆成多个分片,每个节点只负责存储自己那一份,全网存储压力被摊薄。像Bittensor这类去中心化数据网络更激进,把区块日志、模型参数分片上链,单节点负载降到普通服务器就能扛的水平。
你们团队跑节点是全量存还是做了裁剪?存储成本占运维预算几成?
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。